EU-Kommission plant 2025 mit dem Digital-Omnibus-Verfahren eine Vereinfachung der Digitalregulierung, darunter Änderungen an DSGVO und KI-Verordnung. Parallel zeigt eine Preprint-Studie (arxiv, Februar 2025), dass viele LLM-Systeme auf Cloud-Dienste setzen und damit Datenschutzrisiken erzeugen. Mittelständische Unternehmen, die LLM-Finetuning oder lokale RAG-Systeme einsetzen, stehen vor einem doppelten Anpassungsdruck: Die EU-Regulierung befindet sich im Umbruch, während geschlossene On-Premise-Architekturen laut der Studie nachweislich Datenschutz- und Sicherheitsanforderungen besser erfüllen. Wer jetzt auf offene Cloud-Lösungen setzt, riskiert Nachbesserungsbedarf, sobald neue Compliance-Vorgaben greifen.
Datenschutz-by-Design für LLM-Finetuning und lokale RAG-Systeme: Was Mittelständler jetzt konkret tun müssen
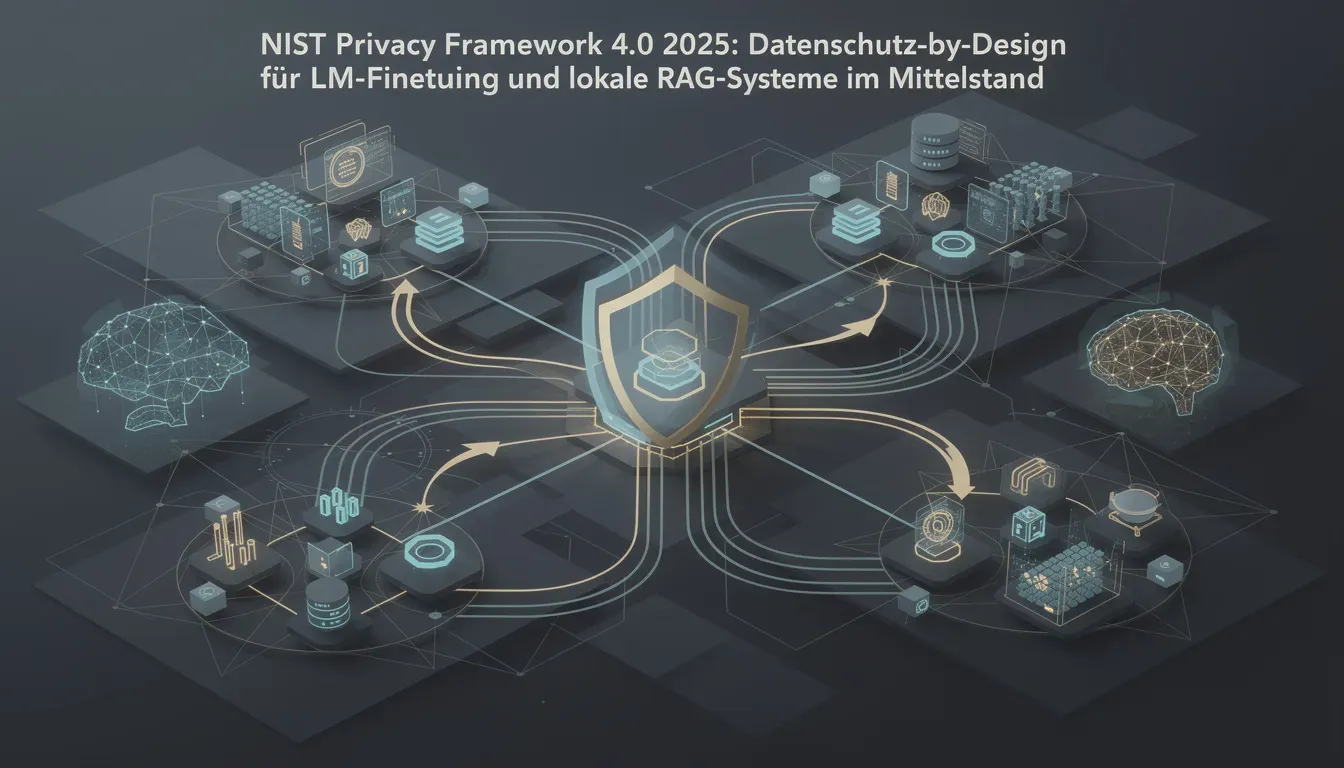
Viele LLM-basierte Lösungen werden als offene Systeme betrieben, die auf Cloud-Dienste angewiesen sind und Risiken für die Vertraulichkeit und Sicherheit von Daten mit sich bringen. Das stellt Unternehmen im Mittelstand vor eine konkrete Aufgabe: Wer Large Language Models für eigene Zwecke feintrainiert oder Retrieval-Augmented-Generation-Systeme (RAG) lokal betreibt, muss Datenschutzanforderungen bereits in der Architekturentscheidung verankern, nicht erst nachträglich als Kontrollschicht aufsetzen.
Dieser Befund stammt aus einem im Februar 2025 auf arXiv veröffentlichten Preprint, das eine Open-Source-Referenzarchitektur für geschlossene LLM-Systeme vorstellt. Die Autoren beschreiben, wie Rechenkapazitäten, Datenverwaltung, Skalierbarkeit und Sicherheitsrisiken in solchen Systemen zusammenwirken, und präsentieren eine Evaluationspipeline zur systematischen Bewertung von Systemleistung und Compliance. Parallel arbeitet die EU-Kommission im Rahmen ihrer sogenannten Simplifizierungsagenda daran, bestehende Digitalregulierung, darunter Teile der DSGVO und des EU-AI-Acts, zu entschlacken. Heise berichtet, dass entsprechende Änderungen über ein Omnibusverfahren eingebracht werden sollen, das mehrere Gesetze in einem Schritt anpasst. Kritiker warnen, dass dabei Bürgerrechte geschwächt werden könnten.
Vier praktische Implikationen für Entscheider im Mittelstand
1. Geschlossene Systemarchitektur als Ausgangspunkt wählen
Die Referenzarchitektur aus dem arXiv-Preprint empfiehlt, LLM-Systeme von Anfang an als geschlossene Systeme zu konzipieren: kein unkontrollierter Abfluss von Trainingsdaten oder Anfragen an externe Cloud-Endpunkte. Für mittelständische Unternehmen bedeutet das konkret, den gesamten Inferenz- und Finetuning-Prozess auf eigener oder dedizierter Infrastruktur zu halten. On-Premise-Deployments kleiner Sprachmodelle sind dabei technisch realisierbar; lesen Sie dazu auch den Überblick zu kleineren Modellen für lokalen Betrieb.
2. Datenverwaltung und Zugriffskontrollen vor dem Finetuning definieren
Wer ein Modell auf internen Unternehmensdaten feintrainiert, muss vorab klären, welche Datenkategorien verarbeitet werden, wer Zugriff auf Trainingsdaten und Modellgewichte hat und wie Löschanfragen operativ umgesetzt werden. Die Referenzarchitektur benennt Datenverwaltung explizit als eine der zentralen Herausforderungen bei der Implementierung. Ergänzende Anforderungen aus DSGVO-Perspektive, insbesondere zur Auftragsverarbeitung beim LLM-Deployment, finden sich in den EDPB-Leitlinien 2025.
3. RAG-Systeme lokal betreiben und Retrieval-Quellen datenschutzrechtlich prüfen
Lokale RAG-Systeme reduzieren das Risiko, dass Suchanfragen und kontextualisierte Dokumente an Drittanbieter übermittelt werden. Entscheidend ist jedoch auch, welche Dokumente in den Retrieval-Index aufgenommen werden: Enthält dieser personenbezogene Daten, greifen DSGVO-Anforderungen an Speicherbegrenzung und Zweckbindung. Einen praxisnahen Einstieg in DSGVO-konforme RAG-Architekturen für den Mittelstand bietet der Artikel zu datenschutzkonformen RAG-Systemen und lokalen LLMs.
4. Regulatorische Unsicherheit einkalkulieren: EU-Omnibus-Prozess beobachten
Die EU-Kommission hat 2025 bereits sechs Omnibus-Gesetzgebungsvorschläge eingebracht, die unter anderem die DSGVO und den EU-AI-Act betreffen. Heise zufolge sollen dabei Meldepflichten und Dokumentationsanforderungen für bestimmte KI-Systeme vereinfacht werden. Für Mittelständler, die aktuell Compliance-Architekturen aufbauen, bedeutet das: Die geltenden Anforderungen als Baseline nehmen, aber Prozesse so dokumentieren, dass sie bei Änderungen schnell angepasst werden können. Den Stand der Änderungsvorhaben zum EU-AI-Act im Rahmen des Omnibus-Verfahrens beschreibt der Artikel zum Digital-Omnibus und seinen Folgen für KI-Regulierung und Datenschutz sowie die allgemeine NIST Privacy Engineering Perspektive für LLM-Systeme im EU-Kontext.
Quellen
- Datenschutzkonformer LLM-Einsatz: Eine Open-Source-Referenzarchitektur (arXiv, Februar 2025)
- Wie der Digital-Omnibus die EU-Datenschutz- und KI-Regulierung ändern soll (Heise, 2025)
Häufige Fragen
Warum reicht der Einsatz eines Cloud-basierten LLM für datenschutzkonforme Anwendungen im Mittelstand oft nicht aus?
Cloud-basierte LLM-Lösungen werden häufig als offene Systeme betrieben, die personenbezogene oder vertrauliche Unternehmensdaten an externe Dienstleister übermitteln. Laut einer im Februar 2025 veröffentlichten Open-Source-Referenzarchitektur (arxiv.org) gehen damit konkrete Risiken für die Vertraulichkeit und Sicherheit der Daten einher. Für Organisationen, die DSGVO-Vorgaben einhalten müssen, sind geschlossene, lokal betriebene Systeme deshalb oft die rechtssicherere Wahl.
Was ist eine geschlossene LLM-Architektur und wie hilft sie beim Datenschutz-by-Design?
Eine geschlossene LLM-Architektur hält alle Datenverarbeitungsschritte innerhalb der eigenen Infrastruktur und verzichtet auf externe Cloud-Dienste. Eine im Februar 2025 publizierte Referenzarchitektur zeigt, dass sich solche Systeme mit Open-Source-Technologien so aufbauen lassen, dass sie strenge Datenschutz- und Sicherheitsanforderungen erfüllen. Datenschutz-by-Design bedeutet dabei, Datenschutzprinzipien bereits in der Systemarchitektur zu verankern, nicht erst nachträglich hinzuzufügen.
Welche technischen Herausforderungen müssen Mittelständler beim Aufbau lokaler RAG-Systeme einplanen?
Laut der Open-Source-Referenzarchitektur vom Februar 2025 zählen ausreichende Rechenkapazitäten, strukturierte Datenverwaltung, Skalierbarkeit und die Absicherung gegen Sicherheitsrisiken zu den zentralen Hürden. Hinzu kommt die Notwendigkeit einer systematischen Evaluationspipeline, mit der sich Systemleistung und Compliance laufend überprüfen lassen. Gerade für den Mittelstand bedeutet das einen erheblichen initialen Planungsaufwand.
Wie verändert der geplante EU Digital-Omnibus die regulatorischen Anforderungen an LLM-Systeme?
Die EU-Kommission verfolgt 2025 mit ihrer sogenannten Simplifizierungsagenda das Ziel, bestehende Digitalgesetze zu entschlacken und bürokratischen Aufwand zu reduzieren. Im Rahmen von Omnibusgesetzen sollen dabei unter anderem die DSGVO und die KI-Verordnung angepasst werden, wie Heise Online berichtet. Kritiker warnen jedoch, dass geplante Änderungen an der DSGVO Bürgerrechte schwächen könnten. Für Unternehmen, die LLM-Systeme betreiben, bleibt die Rechtslage bis zum Abschluss der Verfahren ungewiss.
Welche Vorteile bietet der Einsatz von Open-Source-Technologien für datenschutzkonformes LLM-Finetuning?
Open-Source-Technologien ermöglichen volle Transparenz über die eingesetzten Komponenten, da der Quellcode einsehbar und prüfbar ist. Die im Februar 2025 vorgestellte Referenzarchitektur hebt hervor, dass solche Lösungen flexibel an spezifische Datenschutzanforderungen angepasst werden können, ohne von proprietären Anbietern abhängig zu sein. Für den Mittelstand bedeutet das eine bessere Kontrolle über Datenflüsse und eine nachvollziehbarere Compliance-Dokumentation gegenüber Aufsichtsbehörden.
Dieser Artikel wurde von einem KI-System automatisiert erstellt. Kennzeichnung gemäß Art. 50 der EU-KI-Verordnung.